


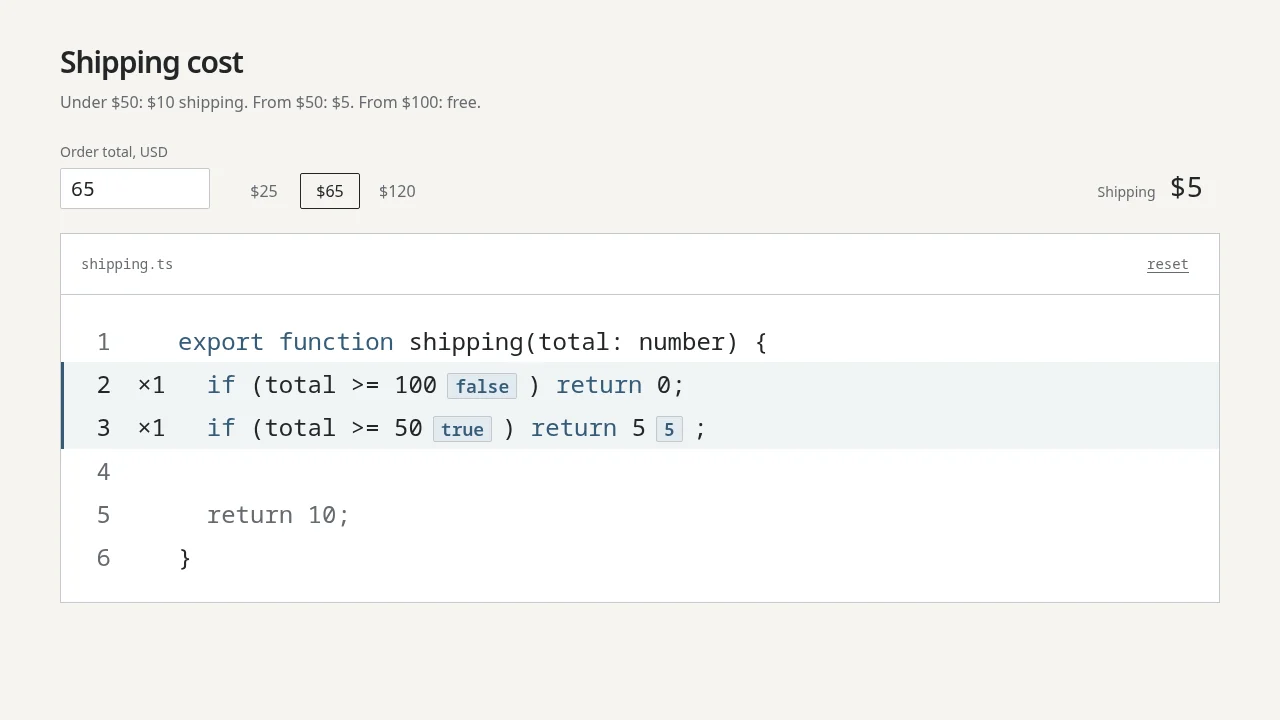
Мне захотелось видеть прямо в коде, какие выражения выполнились и какие значения получились. Без console.log, который нужно сначала везде добавить, а потом ещё убрать.
Так появился code-trace. Запускаешь функцию — рядом с кодом появляются значения. Меняешь аргументы и запускаешь ещё раз — видишь новые значения и отмеченные места, до которых дошло выполнение.
Давайте разберёмся, как это работает. Начнём с функции на три строки.
Просто обернём значение
Допустим, у нас такая проверка:
function check(age) {
    if (age >= 18) return "Проходи";
    return "Пока рано";
}
Обернём age >= 18 в trace: она выведет значение в консоль и вернёт его обратно. Проверка продолжит работать как раньше.
function trace(label, value) {
    console.log(label, value);
    return value;
}

function check(age) {
    if (trace("age >= 18", age >= 18)) return "Проходи";
    return "Пока рано";
}

check(16);
// age >= 18 false
Вся хитрость в return value. Если вернуть просто true, мы уже не наблюдаем за программой, а помогаем несовершеннолетним пройти проверку. 🙂
Теперь добавим ещё одно условие:
function check(age, hasInvite) {
    if (trace("age >= 18", age >= 18)) {
        if (trace("hasInvite", hasInvite)) {
            return trace("ответ", "Проходи");
        }
        return trace("ответ", "Нужно приглашение");
    }
    return trace("ответ", "Пока рано");
}

check(20, false);
// age >= 18 true
// hasInvite false
// ответ Нужно приглашение
Работает. Но функция уже наполовину состоит из отладки. Вложенных условий станет больше — обёрток тоже. А потом их ещё удалять.
Хочется оставить исходник в покое и расставить эти вызовы автоматически. Но сначала нужно найти в коде выражения, которые будем оборачивать.
Может, найдём скобки после if?
Для if (age >= 18) идея выглядит вполне рабочей. Ищем if, берём текст между скобками, вставляем trace.
Потом встречается такое:
if (users.some((user) => user.roles.includes("admin"))) {
    openPanel();
}
Скобок уже несколько. Добавим строки, комментарии, шаблонные литералы — и наш поиск постепенно превращается в собственный разборщик JavaScript. А ведь мы всего лишь хотели посмотреть, что вернула функция.
И ведь нужен не только if. Нас интересуют и выражения после return, справа от = при объявлении переменных, в условиях циклов и тернарных операторах.
Здесь важно различать return и выражение после него. В return result мы оборачиваем только result: получаем return trace("ответ", result). Сам return остаётся на месте и возвращает полученное значение.
Если хочется подробнее разобраться в различии между инструкциями и выражениями, у Josh W. Comeau есть наглядная статья с примерами.
Код можно читать как дерево
Вместо поиска по тексту можно разобрать код парсером. Он построит AST — абстрактное синтаксическое дерево. Это вложенные объекты, которые описывают части кода: условия, вызовы функций, строки. Теперь условие if и строка "if" — разные узлы дерева, и перепутать их уже не получится.
Если с AST пока не знакомы, у Bohdan Liashenko есть подробный разбор на примерах JavaScript: как из текста получается дерево и как с ним работают Babel, инструменты рефакторинга и Prettier.
Возьмём маленький пример:
if (age >= 18) allow();
Вот упрощённая схема AST для этого примера в формате, который возвращает наш парсер. Покажем только нужные нам поля и узлы:
Program
└─ body[0]: IfStatement
   ├─ test: BinaryExpression (operator: >=)
   │  ├─ left: Identifier (name: age)
   │  └─ right: Literal (value: 18)
   └─ consequent: ExpressionStatement
      └─ expression: CallExpression
         ├─ callee: Identifier (name: allow)
         └─ arguments: []
Нам больше не нужно гадать по скобкам. В этом дереве IfStatement.test — выражение age >= 18, а consequent — то, что выполнится, если условие истинно.
Для return result парсер создаст узел ReturnStatement, а в его поле argument положит выражение result. У пустого return; это поле будет null.
Наш парсер также добавляет узлам позиции start и end в исходнике. Например, у условия здесь start: 4 и end: 13: source.slice(4, 13) вернёт age >= 18. Названия полей и формат позиций зависят от парсера — дальше используем формат Oxc.
Такие деревья используют инструменты анализа и преобразования кода. Линтер может искать подозрительную конструкцию, форматтер — печатать код по своим правилам, а мы — находить места для наблюдения.
Какой парсер брать
Нам нужен парсер, который разберёт наш код и покажет, где начинается и заканчивается каждое выражение.
Есть несколько привычных вариантов:
| Вариант | Когда удобен | Что учитывать |
|---|---|---|
| Babel parser | Уже используешь Babel | По умолчанию AST отличается от ESTree. Есть плагин estree для совместимости |
| Acorn | Нужно разобрать обычный JavaScript | Для JSX и TypeScript нужны дополнительные плагины |
| TypeScript Compiler API | Нужны не только узлы кода, но и информация о типах | Собственный формат дерева; информацию о типах получаем отдельно через TypeChecker |
| Oxc | Нужно разбирать JavaScript, TypeScript и JSX | Разбор TypeScript сам по себе не означает проверку типов |
ESTree — распространённое описание структуры AST для JavaScript. Но «все парсеры возвращают одинаковое дерево» из этого не следует. Даже похожие узлы могут отличаться полями. Переносить обход между библиотеками вслепую я бы не стал.
Я взял то, что уже было доступно через Vite. Писать свой парсер ради нескольких значений рядом с кодом пока не хочется. Есть и другие способы испортить себе выходные. 😞
Находим места для обёрток
Сначала отметим выражения, значения которых хотим увидеть. Каждое такое место будем называть точкой наблюдения, а в коде — probe. Пока нам нужны только его границы в исходнике:
type Probe = { start: number; end: number };
Ни значения, ни количества срабатываний здесь ещё нет. Код мы только прочитали, он пока не выполнялся.
Вот сокращённая версия сбора этих точек, с теми же импортами, что в проекте:
import { parseSync, Visitor } from "vite";

const source = "if (age >= 18) allow();";
const { program, errors } = parseSync("example.js", source, {
    preserveParens: false,
});

if (errors.length) throw new Error("Не удалось разобрать код");

const probes: { start: number; end: number }[] = [];

new Visitor({
    IfStatement(node) {
        probes.push({ start: node.test.start, end: node.test.end });
    },
    ReturnStatement(node) {
        if (node.argument) {
            probes.push({ start: node.argument.start, end: node.argument.end });
        }
    },
}).visit(program);

console.log(probes);
// [{ start: 4, end: 13 }]
console.log(source.slice(probes[0].start, probes[0].end));
// age >= 18
Visitor обходит дерево, включая вложенные конструкции. Мы описываем, что делать при встрече с нужным типом узла. Вложенный if найдётся так же, как внешний.
У пустого return; аргумента нет, поэтому проверка нужна. Оборачивать там нечего.
В полной реализации точек больше: условия while, do...while и for, выражение у switch, аргумент throw, проверка тернарного оператора, выражения справа от = при объявлении переменных и тела стрелочных функций без блока. Есть и отдельные выражения вроде save();.
При этом директивы вроде "use strict" пропускаются. Выражения функций и классов справа от = в объявлениях переменных тоже пропускаются. Оборачивать всё подряд нельзя: в некоторых случаях это изменит поведение кода.
Добавляем обёртки в исходник
Для одного условия преобразование выглядит так:
// Было
if (age >= 18) allow();

// Стало: показываем только обёртку условия
if (__trace$(0, age >= 18)) allow();
0 — идентификатор точки, её индекс в массиве.
А зачем дополнительные скобки вокруг выражения? Допустим, в коде есть return (save(), 42): сначала вызывается save(), а затем возвращается 42. Здесь запятая позволяет выполнить несколько выражений и взять значение последнего.
При добавлении обёртки скобки нужно сохранить:
// Без скобок: передали три аргумента вместо двух
return __trace$(0, save(), 42);

// Со скобками: второй аргумент — результат всего выражения, то есть 42
return __trace$(0, (save(), 42));
В первом случае обёртка получит результат save() вместо 42. Поэтому мы всегда добавляем скобки вокруг выражения, которое оборачиваем.
Но если вставить текст в начало строки, все последующие координаты съедут. Поэтому в проекте сначала собираются вставки, а потом за один проход склеивается результат из кусочков исходной строки. Исходник во время прохода не меняется.
Для каждой точки получается две вставки:
{ at: start, text: `__trace$(${id}, (` }
{ at: end, text: "))" }
С вложенностью тоже надо быть аккуратнее. Например, у выражения справа от = и проверки тернарного выражения может совпасть начало:
const label = age >= 18 ? "Можно" : "Нельзя";
Тут мы хотим узнать и результат проверки, и выбранную строку:
const label = __trace$(0, __trace$(1, age >= 18) ? "Можно" : "Нельзя");
Если открывающие вставки стоят в одной позиции, первой должна идти внешняя — та, которая оборачивает более длинное выражение. А на границе соседних выражений сначала закрываем закончившуюся обёртку, потом открываем новую. Именно этим занимается сортировка в wrap-probe.ts.
Можно было менять само дерево и заново печатать весь файл. Я здесь ограничился вставками: для этой задачи достаточно, и исходное форматирование остаётся на месте.
Откуда берутся значения
Парсер видит выражение age >= 18, но не знает, какое значение придёт в age и что получится при сравнении. Чтобы это узнать, нужно выполнить код. Поэтому мы добавляем обёртки: когда программа дойдёт до выражения, обёртка получит его результат, сохранит для отображения и вернёт обратно.
В упрощённом виде runtime такой:
const values = new Map<number, unknown>();
const hits = new Map<number, number>();

function __trace$<T>(id: number, value: T): T {
    values.set(id, value);
    hits.set(id, (hits.get(id) ?? 0) + 1);
    return value;
}

__trace$(0, 20 >= 18);
__trace$(0, 16 >= 18);

console.log(values.get(0)); // false
console.log(hits.get(0)); // 2
Выражение вычисляется один раз, до передачи в функцию. Для вызовов с побочными эффектами это принципиально:
const item = __trace$(0, queue.shift());
Если сначала вызвать queue.shift() ради лога, а потом ещё раз ради результата, очередь внезапно похудеет на два элемента. Очень полезный отладчик получится.
В настоящем runtime мы сохраняем короткое описание значения. Вот что попадёт в values:
import { __trace$, values } from "@toolkit/code-trace/runtime";

__trace$(0, [10, 20, 30]);
__trace$(1, { name: "Anna", age: 20 });
__trace$(2, function greet() {});

console.log(values.get(0)); // Array(3)
console.log(values.get(1)); // { name, age }
console.log(values.get(2)); // ƒ greet
Так в подписи поместится даже большой массив. Его содержимое мы не копируем — записываем только описание.
Набор run хранит номера точек, которые сработали в текущем запуске. Начнём новый запуск и посмотрим, что осталось:
import { __trace$, values, hits, run, startRun, reset } from "@toolkit/code-trace/runtime";

reset();
__trace$(0, 42);

console.log([...run]); // [0]

startRun();
console.log([...run]); // [] — в новом запуске пока ничего не сработало
console.log(values.get(0)); // "42" — последнее значение осталось
console.log(hits.get(0)); // 1 — счётчик тоже

reset();
console.log(values.size, hits.size, run.size); // 0 0 0
А если точка сработает сто раз в цикле? Значение и счётчик обновятся сто раз, но подписчик получит одно уведомление:
import { __trace$, subscribe } from "@toolkit/code-trace/runtime";

let updates = 0;
const unsubscribe = subscribe(() => updates++);

for (let i = 0; i < 100; i++) {
    __trace$(0, i);
}

console.log(updates); // 0
await Promise.resolve(); // даём выполниться очереди микрозадач
console.log(updates); // 1

unsubscribe();
Для этого runtime откладывает уведомление через queueMicrotask. Пока код выполняется синхронно, новые срабатывания не добавляют уведомлений в очередь. Цикл закончится — интерфейс получит обновление сразу со всеми накопленными изменениями.
Собираем это в Vite
У меня есть небольшой проект, где я пробую разные идеи и собираю понравившиеся компоненты. Там же я сделал code-trace и добавил playground, чтобы проверять его на живых примерах.
Playground работает на Vite, поэтому через плагин удобно связать всё вместе: найти нужные выражения, добавить обёртки и показать значения рядом с исходником.
Подключается он так:
import { codeTrace } from "@toolkit/code-trace/vite";
import { defineConfig } from "vite";

export default defineConfig({
    plugins: [codeTrace()],
});
А в HTML указывается файл для отображения:
<code-trace src="example.ts"></code-trace>
<script type="module" src="./main.ts"></script>
Плагин находит такие элементы и запоминает их файлы. Для интерфейса загружает исходный текст через ?raw и координаты через собственный запрос ?probes. Когда приложение импортирует сам модуль, transform добавляет обёртки и импорт runtime.
На экране мы показываем исходный код, а запускаем версию с добавленными вызовами __trace$. Загруженные текст и координаты передаются веб-компоненту, который расставляет рядом с выражениями небольшие подписи со значениями.
Сам элемент функцию не запускает. В playground это делает обработчик ввода:
import { startRun } from "@toolkit/code-trace/runtime";
import { check } from "./example.ts";

const input = document.querySelector("input")!;

input.addEventListener("input", () => {
    startRun();
    check(Number(input.value));
});
Меняем число — выполняется check, обновляются значения, подсвечиваются строки со сработавшими точками. Счётчик строки берётся как максимум счётчиков её точек, а не их сумма: два выражения на одной строке сами по себе не означают два прохода строки.
А почему не debugger?
Иногда именно он и нужен.
Если надо остановиться внутри функции, посмотреть стек, замыкания и состояние объектов — я бы открыл DevTools. Если интересует одно значение — поставил бы console.log. Собирать вокруг этого плагин необязательно.
Мне хотелось сделать это наглядно: запускаешь пример — и прямо рядом с кодом видно, какие выражения выполнились и какие значения получились. Без настройки точек останова и расставленных вручную логов. В playground достаточно поменять число в поле ввода.
За похожие возможности некоторые инструменты берут деньги. Мне было интересно попробовать собрать свой вариант и разобраться, как это работает.
Code-trace удобен для другого сценария: перед глазами небольшой алгоритм, меняешь входные данные и сразу видишь, что произошло. Например, разбираешь ранние возвраты, объясняешь цикл или проверяешь несколько веток в учебном примере.
Есть ещё инструменты покрытия тестами: они помогают найти непосещённые строки и ветки. Но вопрос «выполнялась ли эта ветка» отличается от «какое значение здесь получилось». В code-trace меня интересовало второе вместе с видимым путём выполнения.
Где заканчивается магия
У code-trace пока есть несколько ограничений.
В a && b правая часть выполняется, только если левая даёт истинное значение. Обёртка сохраняет это поведение. Если b не выполнилось, показать его результат мы не сможем.
С ошибками тоже есть нюанс. Если при вычислении выражения возникла ошибка, __trace$ не вызовется: аргумент вычисляется раньше. А вот в throw new Error(...) мы успеваем записать описание созданного объекта ошибки, прежде чем код его выбросит.
Для каждой точки сохраняется только последнее значение. Если цикл прошёл сто раз, все сто результатов посмотреть не получится. Истории значений и порядка вызовов здесь нет. А startRun() просто отмечает начало нового запуска. Если две асинхронные операции выполняются одновременно, их результаты могут смешаться.
С несколькими файлами пока тоже не всё готово. В каждом нумерация точек начинается с нуля, а значения хранятся вместе. Поэтому точку 0 из одного файла можно перепутать с точкой 0 из другого. Нужно добавить привязку к файлу.
Имя __trace$ пока фиксированное: если в исходнике уже есть такая переменная, возникнет конфликт. Source map тоже пока нет — связать позиции в изменённом коде с исходником будет сложнее.
И ещё: вернуть то же значение не всегда достаточно. Например, JavaScript может дать анонимной функции имя переменной, в которую её записали. Обёртка этому помешает, поэтому такие функции и классы мы пропускаем. Каждый новый случай приходится проверять отдельно.
Для небольшого playground этих возможностей уже хватает. Для универсального отладчика на весь проект работы ещё прилично.
Мне здесь больше всего нравится, что начать можно с функции на три строки. Потом появляется вопрос «а как расставить её автоматически?» — и вот уже AST перестаёт быть чем-то исключительно для авторов компиляторов.
Полная реализация лежит в моём toolkit, пакет code-trace. Начать смотреть можно с instrument/collect-probes.ts, затем wrap-probe.ts и runtime/index.ts. А в playground — пример, где всё это соединено с вводом числа и отображением кода.
Удачи с экспериментами! Пусть код работает, а кофе не успевает остыть ☕